Modelo portátil y nativo de Git para memoria de IA legible por agentes
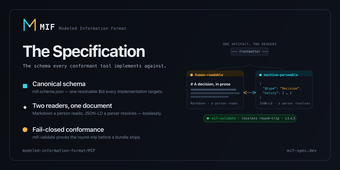
MIF (Formato de Información Modelada), de Formato de Información Modelada, proporciona un modelo de datos neutral ante proveedores para el intercambio de conocimiento de IA portátil. Agrupa Markdown editable por humanos y JSON-LD consumible por máquinas para crear paquetes de conocimiento legibles por agentes y de primera local para asistentes integrados en MCP y flujos de trabajo agénticos. Los elementos clave incluyen una fuente de Markdown canónica, proyecciones JSON-LD derivadas, procedencia PROV de W3C, validez bi-temporal e integración con servidores MCP. Los ingenieros de IA y los gestores de conocimiento lo utilizan para mantener la memoria de IA nativa de Git y reducir la sobrecarga de tokens.
¿Qué tareas puedes utilizar realmente MIF?
MIF aborda el problema de la memoria persistente de la IA produciendo paquetes de contexto consumibles por agentes que los agentes pueden navegar con alta precisión. El formato define tipos semánticos, episódicos y procedimentales y soporta relaciones tipadas para mapear entidades complejas. Los equipos utilizan esos paquetes para exponer contexto estructurado a los asistentes durante la resolución de indicaciones, para mantener una fuente de verdad editable por humanos y para representar el conocimiento de una manera que los agentes puedan consultar programáticamente.
¿Qué tan precisas y trazables son las proyecciones legibles por máquina?
Las proyecciones derivadas incluyen metadatos alineados con W3C PROV y seguimiento bi-temporal para documentar el origen y la frescura, lo que mejora la trazabilidad para el procesamiento posterior. La precisión de las salidas orientadas a agentes depende de la calidad del Markdown canónico, ya que los humanos son quienes crean la fuente de verdad. Prácticamente, la fiabilidad aumenta cuando los autores incluyen campos de procedencia y ventanas de validez explícitas durante la creación, porque el formato se basa en esas señales para evitar que se sirva contexto obsoleto.
¿Qué entradas y patrones de implementación son necesarios?
El flujo de trabajo es nativo de sistema de archivos y Git, por lo que los proyectos almacenan paquetes de conocimiento como archivos de texto plano en lugar de en bases de datos vectoriales externas. MIF puede funcionar como un servidor MCP (mif-mcp) e integrarse con clientes que soportan el Protocolo de Contexto de Modelo; la implementación se adapta a entornos de Node.js y TypeScript y a integraciones comunes de editores como VS Code. El diseño elimina una capa de base de datos obligatoria y permite a los equipos mantener la memoria dentro de un repositorio de proyecto.
¿Es MIF práctico en comparación con sistemas de memoria respaldados por bases de datos?
MIF enfatiza la portabilidad neutral al proveedor sobre las características de la base de datos utilizando Markdown plano como el artefacto canónico, lo que evita el bloqueo a formatos de almacenamiento propietarios. Su cumplimiento con OKF ayuda a la interoperabilidad con otras herramientas que utilizan el mismo modelo de transporte. Los proyectos que necesitan experimentación rápida con memoria de primera local y procedencia explícita pueden adoptarlo sin introducir un almacén vectorial externo, aunque adaptar tuberías existentes puede requerir mapear esquemas actuales al modelo de contenido opinado de MIF.
MIF se adapta a equipos de ingeniería que priorizan un contexto de IA portátil y revisable
MIF es una opción práctica para ingenieros de IA y gerentes de conocimiento que necesitan memoria portátil y de primera local que los agentes puedan leer. Su principal limitación es la dependencia de archivos fuente curados para la corrección de salida, por lo que los equipos deben añadir pasos de revisión y validación del autor en su flujo de contenido. Tratado como parte de un flujo de trabajo de verificación más amplio, se ajusta a proyectos que prefieren memoria nativa de repositorio sobre servicios de bases de datos externas.